シンクロ・フード エンジニアブログ

飲食店ドットコムを運営する、株式会社シンクロ・フードの技術ブログです

AI時代のジュニアエンジニア育成で、『自走』をどう見極めるか

はじめに

こんにちは。はじめまして。
開発部第四開発グループの橋本です。

シンクロ・フード開発部では、今期よりClaude Codeを全面採用し、開発における運用を始めています。

確かにAI導入により、開発工程における効率は上がりました。それにより一定の成果を出すことはできています。
が、世間一般の中小規模の開発組織のご多分に漏れず、レビュー・テスト工程を着実にこなすことができるミドル層・シニア層が不足してボトルネック化し、AIによる爆発的な速度改善を十分に活かしきれているとは言えません。
こちらについては、多くの開発組織のマネージャー陣が実感されていることだと思いますので、今更触れません。

弊社では、今はボトルネックを通る部分をいかに少なくするか、つまりはレビュー・テスト工程においてAIをどこまで取り込むかという議論を進めていますが、一方で長期的には狭いボトルネックをいかに広げるか、という課題にも取り組んでいかねばなりません。

そうです。
つまるところジュニアエンジニア育成です。

もちろんミドル層・シニア層の採用による獲得、というのも選択肢の一つです。
しかし、この層の不足は弊社としての課題でもありますが、IT業界全体における課題でもあります。
以前から言われてきたことではありますが、AIの進化によってより深刻化していくでしょう。
採用難易度もますます上がっていくでしょう。

この記事では、そんなAI時代にジュニア育成に取り組む中で見えてきた課題の一つについて触れています。
それは 「ジュニアエンジニアからの質問が減った」 ことです。

AIを導入すると、ジュニアエンジニアは質問しなくなる

AIを導入すると、新人が先輩に聞かなくても進められる場面が増えます。
コードの読み解き、エラー調査、実装案の検討、テストコードの作成。
以前なら先輩やマネージャーに聞いていたことも、まずAIに聞けばとりあえず進めることができます。

質問が減る→タスクが止まりにくくなる→PRが早く出てくる→一人で完了できる仕事が増える。

外から見ると、かなり「自走できるようになった」ように見えます。
しかし、これは本当でしょうか?

そもそも、これまで何をもって「自走」と見ていたのか

これまでジュニアエンジニアの成長を見るとき、

  • 「自分で調べられる」
  • 「細かく聞かなくても進められる」
  • 「一人でタスクを完了できる」

といった状態を、ある程度「自走できている」と見ていました。

しかし、開発においてAIを使うようになった今、彼らはAIが書いた設計、AIが書いた実装、AIが書いたテストについて、なぜそうしたのか、なぜそうしなければならなかったのかを理解できているでしょうか?

最近公開されているジョブサポートによる新人・若手エンジニアの生成AI利用調査では、

「出力されたコードの仕組みや根拠を本人が理解していない」(61.4%)

という結果が出ています。

海外でも、BairesDevという企業が行った77か国・1,569人の開発者を対象とした調査で、ジュニアエンジニアの85%が「AIによってソフトウェア開発への理解が深まった」と回答した一方、同じジュニアと働くシニアエンジニアで「ジュニアがAI生成コードを完全に理解している」と回答したのは16%にとどまりました。

また、ACM Conference on International Computing Education Research (ICER)に投稿された初心者プログラマー21名を観察した研究では、21名中20名がAIを使って課題を完了できました。一方で、参加者の一部には、自身の問題解決能力を実際より高く見積もる「illusion of competence(能力の錯覚)」も観察されています。

つまりAIによって「できた」という結果と「わかった」「できるようになった」という成長が、以前より乖離しやすくなっています。

実際に、もともと考えていた「自走しているときに現れるサイン」を満たしていても、何故こういう実装にしたの?と聞くと「AIがそう言ってたから」と答えてしまうジュニアエンジニアが一定数います。

AIが間に入って最終的にタスクが完了してしまえば、

  • 本人が理解して進めているのか。
  • AIに逐次聞きながら進めているのか。
  • 正しい問いを立てているのか。
  • AIが出した答えを検証できているのか。

は外からは判断できません。

つまりAIによって「自走しているときに現れるサイン」だけを再現することは簡単になってしまったということです。

AI時代に必要になる『評価する力』

2026年にScienceに掲載された研究では、生成AIを最も頻繁に利用していたのはジュニアエンジニアだった一方、測定可能な生産性向上が確認されたのはシニアエンジニアでした。
この結果だけでジュニア育成について断定はできませんが、AIを使うこと自体と、AIを使って適切に判断する能力は別物だと考える材料にはなります。

さらに、AIコーディング支援を利用するプロフェッショナルなソフトウェアエンジニアを追った研究では、仕事の重心がコードの「生成」から、AIの出力を指示・評価・修正する方向へ移っているとして、それを “supervisory engineering work” と整理しています。

こうした変化を考えると、これから重要になるのは「作れること」以上に、「出てきたものを評価できること」なのかもしれません。
そしてジュニア育成では、その「評価するための物差し」をどう身につけるかが問題になります。

AIが埋めているのは「知識不足」だけではない

確かにAIは便利です。
ジュニアエンジニアが自分ではうまく整理できていない問題でも、ある程度補完しながら前へ進めてくれます。
これは単に振られたタスクをこなすという意味では大きなメリットだと言えると思います。

一方で、育成という視点では明確にデメリットとなる点が多々あります。
ジュニアエンジニアは必ずしも「正しい問い」を立てられるとは限りません。

本当は仕様を確認するべき場面で、
「このエラーをどう直せばいいですか」
と聞くかもしれない。

設計自体を疑うべき場面で、
「この実装を通すにはどうすればいいですか」
と聞くかもしれない。

人間の先輩やマネージャーなら、
「聞きたいことはそれであってる?」「そもそもその前提合ってる?」
と問い返すことができます。

AIも問いを修正してくれることはありますが、常にそうなるとは限りません。
多少ずれた問いでも、それらしい答えを返してしまいます。

実際、初心者がChatGPTと人間のチューターを使った場合の違いを比較した研究では、ChatGPTを使った学生は短いプロンプトを投げ、そこから問いをあまり洗練しない傾向が見られました。一方で、初歩的な質問については、人間に聞くよりも対人的な不安が少ないという理由でChatGPTを好む傾向も報告されています。

AIは「答え」を補完するだけではありません。
場合によっては、「問いを考える力」まで補完し、その不足を本人にも他人にも見えにくくしてしまいます。

AIが補完することで失われるもの

タスクを完了できることと、本人が問題を理解できていることは違う、ということは見えてきました。
これは育成の判断基準が、ひとつ失われたことになります。

AI導入以前は、理解できないところで仕事が詰まりやすいものでした。
詰まれば先輩やマネージャーに質問をすることになります。
質問をすれば、先輩やマネージャーに答えを教えてもらえるかもしれませんし、問いや理解のズレを修正されるかもしれません。
AIは、この「詰まり」を削ってしまいます。

「詰まること」は、一見すると非効率ですが、それは“能力の境界が露出する瞬間”で、その瞬間を捉えて育成タイミングとしていたわけです。
つまり、質問が来なくなるということは、その育成タイミングの喪失も意味します。

さらに、ジュニアエンジニアの「問い」が見えなくなる

もう一つ失われるのが、ジュニアエンジニアが何を疑問に感じていたかという情報です。

ジュニアエンジニアの質問には、

  • どこまで理解できているか
  • 何を問題だと思っているか
  • どこで前提を間違えているか
  • 何を疑問にすら思っていないか

が表れます。

育成側としては、質問に答えること自体より「なぜその質問をしたのか」を知る・考えることのほうが、重要になることもあります。

しかし質問の一次受けをAIが担うと、そのやり取りはジュニアエンジニアとAIの間に閉じてしまって見えません。
先輩やマネージャーから見えるのは、完成したコードとPRだけになります。
つまり単なる質問数ではなく、ジュニアエンジニアの思考過程そのものが見えなくなっているのです。

質問しないことを「成長」と誤認しないためにするべきこと

ここまで見てきたように、AIによって失われるのは、成果物から本人の能力を推測するための材料、詰まりをきっかけにした育成のタイミング、そして本人が何を考えているのかを把握するための情報そのものです。

とはいえ、今更AIを禁止して以前と同じ状態に戻すことは現実的ではありません。
今や小学生でもChatGPTを使っています。(若年層には使わせないようにしようとする国も現れているようですが……)
これまで自然に得られていた育成上の情報や機会を、別の場所で取り戻す必要があります。

現時点では次の3つの方向で育成方法を変えていく必要があると考えています。

  • 「成果」ではなく、「判断」を見る
  • AIとの間に閉じた「問い」を可視化する
  • 意図的に「考える機会」を作る

「成果」ではなく、「判断」を見る

AI時代には、成果物そのものよりも、そこに至る判断を見る必要があります。

  • なぜこの実装を選んだのか
  • 他にどんな選択肢があったのか
  • AIの回答をどう検証したのか
  • どこにリスクがあると考えたのか

といったことを、本人の言葉で説明できるようになってもらいます。

大事なのは、正しい答えを知っているかというよりも、自分で判断する基準を持っているかです。
シニアエンジニアは、すでにAIの出力を評価するための「物差し」を持っています。
AIにコードを書かせても、その出力を疑い、必要であれば修正できます。
一方で、ジュニアエンジニアはその物差し自体をこれから作っていかなければなりません。

「一人で仕事を終えられるか」ではなく、AIを使いながらも最後の判断を自分でできるかを見る、ということです。

AIとの間に閉じた「問い」を可視化する

次に見る必要があるのが、ジュニアエンジニアがどのような問いを立てているかです。
AIとの会話ログをすべて追うのは現実的ではありませんが、レビューやふりかえり、1on1などで確認する機会を作ります。

見たいのはAIの利用履歴ではなく、本人が何を問題として認識していたかです。

正しい問いを立てられているのか。
間違った前提に気付けているのか。
そもそも疑問に持つべきことを見落としていないか。

質問が人間に届かなくなった以上、こうした問いを意識的に会話へ戻すことで、これまで質問から自然に得られていた理解度の情報を取り戻していく必要があります。

意図的に「考える機会」を作る

AIによって「詰まり」が減ること自体は、開発効率という意味では良いことです。
しかし、これまでジュニアエンジニアは、詰まることで考え、質問し、先輩から問い返されるという経験を重ねてきました。
AIによってその機会が減るのであれば、今度は育成側が意図的に「考える機会」を作らなければなりません。

たとえば、

  • 仕様の解釈が必要な場面では、まず本人の解釈を聞く
  • 設計では、複数案とそれぞれのメリット・デメリットを考えてもらう
  • AIが出した案を採用した理由、採用しなかった理由を説明してもらう
  • 「この前提が変わったらどうする?」と条件を変えて考えてもらう
  • AIに聞く前に、自分なりの仮説を一度持ってもらう

といった形です。

こうした考え方に近い研究もあります。
コンピューティング教育研究を扱うACMの国際会議ICER 2026で発表された研究では、学習者にAIが生成した複数のコード候補を比較させることで、「どれが正しいか」だけでなく「なぜ別の案が良くないのか」を考えさせています。複数案を提示された参加者の多くが、立ち止まってより批判的に考えるきっかけになったと振り返っています。

AIを使わせないという話ではありません。
むしろAIは積極的に使いながら、思考そのものまでAIに肩代わりさせないための仕掛けを作るということです。

最後に

一方で、こうした育成方法への転換は、育成側の負荷を上げてしまいます。前述のジョブサポートの調査でも、多くのOJT担当者が指導負担の増加を感じています。
だからこそ、すべてを人間が確認するのではなく、判断過程を外化し、人が介入するポイントを絞る必要があります。
たとえばPRや設計メモに判断理由を残し、仕様解釈や設計判断など育成効果の高い場面だけ人が深く関わる、といった工夫が必要になります。

質問しないこと、一人で完了できることを、そのまま自走と評価せず、代わりに問い・判断・説明を見る。
AIによって「開発の進め方」が変わったように、育成する際の「見るべきもの」も変えていく必要があります。
シンクロ・フードでも、AI時代に合った「自走」の見方と育成方法を、現場で試しながら更新していきます。

参考資料

フルリモートの心理的安全性は右肩上がりにならなかった|サーベイ3回の記録

はじめに

こんにちは、開発部の髙木です。

弊社の開発部は、フルリモートで開発をしています。 フルリモートは働きやすい一方で、「ちょっとした相談がしづらい」「オンラインMTGだと発言のハードルが高い」といった、対面ならなんとなく解消されていたであろう難しさもあります。

弊社では、会社全体で四半期ごとにサーベイ(組織や個人の状態をアンケートで数値化する仕組み)を実施しています。 あるとき、私が所属するチームの「心理的安全性」のスコアが低め、という結果が出ました。 そこからチームでいくつかの施策に取り組み、次のサーベイではスコアが改善しました。 しかし、その次のサーベイでは、また下がってしまいました。

今回は、この「上がって、また下がった」という推移と、そこからチームで何を考え、次に何を確かめようとしているかを書きます。 きれいな成功体験ではありませんが、フルリモートで心理的安全性に向き合っている方の参考になれば嬉しいです。

本記事で扱う「心理的安全性」の範囲

心理的安全性は、失敗の共有、異論や指摘、懸念の表明なども含む広い概念です。 本記事ではそのなかでも、「分からないことを質問する」「困っていることを相談する」といった対人リスクを取りやすい状態に焦点を当てます。 このあと紹介する施策も、この範囲を狙ったものです。

本記事に出てくるスコアについて

スコアは、複数の設問への回答から算出される50点満点の値で、チームメンバーの平均です。 サーベイには多くの項目がありますが、本記事では「心理的安全性」と「職務遂行上のサポート」の二つに絞って紹介します。

サーベイで見えたチームの課題

きっかけは、1回目(2025年11月実施)のサーベイでした。

  • 心理的安全性:38.5
  • 職務遂行上のサポート:42.8

心理的安全性は、チームの他の項目と比べても低く、40を下回っていました。 飛び抜けて悪いというほどではないものの、チームとして気になる項目の一つだったので、腰を据えて向き合ってみることにしました。

結果を眺めていて不思議だったのは、「職務遂行上のサポート」は高いのに、「心理的安全性」は低い、という点です。 サポートが手厚いなら安心して働けているのではないか、と思っていたので、この二つは連動しそうに見えていました。

チームで話していくと、いくつかの仮説が出てきました。

  • サポート自体は手厚いが、そのサポートを受けるまでのハードルが高いのではないか
  • オンラインMTGの雰囲気が固く、発言しづらい
  • 「何か有意義なことを言わないといけない」という無言のプレッシャーがある
  • そもそもフルリモートだと、雑談や軽い相談の総量が減りがち

これらをまとめると、「助けてくれないチーム」ではなく、「助けを求めるまでの心理的なコストが高いチーム」なのではないか、という見立てにたどり着きました。

なぜ心理的安全性を高めたいのか

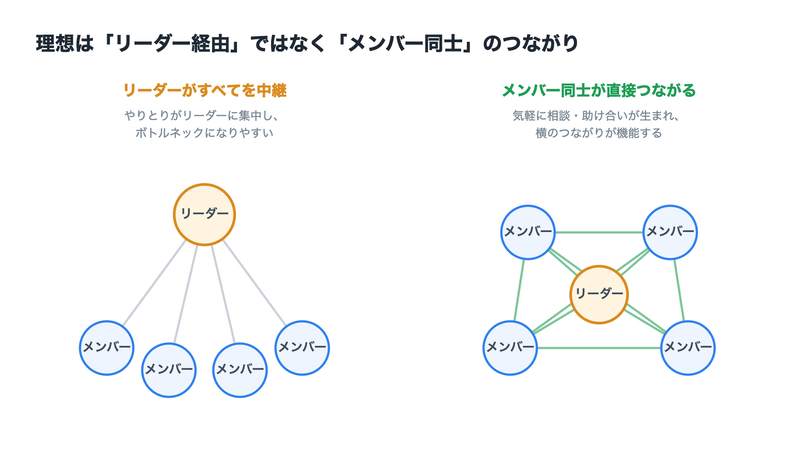
以前リーダー研修を受けた際に、印象に残った学びがありました。 チームがうまく回るには、すべてのやりとりがリーダーを経由する「メンバー → リーダー → メンバー」の形ではなく、「メンバー → メンバー」で直接つながり合える状態が大事だ、というものです。

リーダーがすべての中継点になっている状態は、一見まとまって見えても、リーダーがボトルネックになりがちです。 メンバー同士の助け合いも生まれにくくなると感じています。 理想は、私が間に入らなくても、メンバー同士で気軽に相談し、助け合えるチームです。

その「メンバー同士が直接つながる」土台になるのが心理的安全性だと考えています。 お互いに気兼ねなく質問し合える、指摘し合える空気があることで、リーダーを介さない横のつながりが機能しやすくなると考えています。 サーベイの数値そのものというより、その先にある「メンバー同士でつながれるチーム」をつくりたくて、心理的安全性に向き合うことにしました。

リーダー経由とメンバー同士のつながりの対比

取り組んだこと

この見立てと狙いをふまえ、大がかりな制度ではなく、日々の小さなハードルを下げる施策から始めました。

なんでも相談チャンネルをつくる

Slackには、開発チーム内で日々のやりとりをするチャンネルがあります。 ただ、そこにはちょっとした質問を投げにくい空気がありました。 「これくらい自分で調べるべきかな」「わざわざ聞くほどでもないかな」と、投稿をためらってしまうのです。

そこで、相談や共有を気軽に投げられる「なんでも相談チャンネル」を用意しました。 実装方針の相談でも、ちょっとした疑問でも、気づいたことの共有でも、投げる内容は何でもよい、というゆるい運用です。

MTGでマイクを常時ONにする

オンラインMTGでは、生活音などが入らないよう、発言するとき以外はマイクをミュートにしているメンバーがほとんどでした。 そのため、発言するたびにミュートを解除する一手間が発生します。 この一手間が、地味に発言のハードルを上げているのではないか、と考えました。 そこで、MTG中はマイクを常時ONにすることを試験的にやってみました。 相槌や「うんうん」といった反応が声で返ってくれば、場の空気も和らぐのでは、という狙いです。 在宅環境の事情もあるので、あくまで「試してみて合わなければ見直す」という前提での導入です。

週次で感謝や称賛を伝える場をつくる

フルリモートだと、お互いが何をしているのかが見えにくく、やりとりも業務上必要な最小限になりがちです。 相手の仕事ぶりを知らないままだと、いざ困ったときに「この人に相談してみよう」とはなりにくいと感じていました。

そこで、週次の振り返りのなかで、お互いへの感謝や「これ良かったです」を共有する時間を設けました。 感謝を伝えること自体が目的というより、お互いを知り、認め合う機会をつくることで、メンバー同士が相談し合える関係の土台にしたい、という狙いです。

特定のメンバーしか参加していないMTGの内容を共有する

一部のメンバーだけが出ているMTGの情報が共有されず、メンバー間で情報格差が生まれていました。 情報格差があると、前提知識が足りないことで「こんなことを今さら聞いていいのかな」と質問をためらう状況につながりかねません。 それを防ぐために、そうしたMTGの要点をチームに展開するようにしました。

ここまでの施策を、狙いとあわせて整理すると次のとおりです。

施策 狙い
なんでも相談チャンネル 小さな相談のハードルを下げる
MTGでマイクを常時ONにする 発言のハードルを下げる
週次の感謝や称賛の共有 お互いを知り、相談できる関係の土台をつくる
特定MTGの情報共有 情報格差による「質問しづらさ」を防ぐ

2回目のサーベイ

これらの施策を続けて、2回目(2026年2月実施)のサーベイを迎えました。

  • 心理的安全性:38.5 → 41.4(+2.9)
  • 職務遂行上のサポート:42.8 → 41.4(-1.4)

心理的安全性は2.9ポイント上がりました。 課題として取り組んできた部分だったので、チームとしても素直に嬉しい結果でした。 一方で、もともと高かった職務遂行上のサポートは1.4ポイント下がり、二つの項目が同じ値に並びました。

施策のほうを振り返ると、効いた実感のあるものと、そうでもないものがありました。

  • なんでも相談チャンネル:活発に使われ、「相談しやすくなった」という声もあり、継続することにしました。
  • 感謝や称賛の共有:「こうして共有されると心理的に和らぐ」という声があり、効果を感じられました。一方で「毎回書くのは少し負担」という意見もあり、運用を軽くしながら続けることにしました。
  • マイクの常時ON:人によって効果に差が出ました。ファシリテーターをする機会が多い私自身は、相槌や反応の声が確実に増えて、話しやすくなった実感があります。一方で、ファシリテーターの機会が少ないメンバーには効果を感じにくかったようで、チーム全体で見ると「発言のハードルが下がった」と言い切れるほどではありませんでした。最終的に、全員に強制するものではなく「推奨」という位置づけに落ち着きました。
  • 特定MTGの情報共有:チーム運用として定着し、続けています。スコアへの直接の効果は測りにくいものの、情報格差からくる「質問しづらさ」を減らす下支えにはなっていると感じます。

効果が見えにくかった施策を無理に続けず、運用を見直せたのはよかったと思っています。

3回目のサーベイ

その次、3回目(2026年5月実施)のサーベイでは、スコアがこう動きました。

  • 心理的安全性:41.4 → 40.0(-1.4)
  • 職務遂行上のサポート:41.4 → 43.3(+1.9)

3回分をまとめると、次のとおりです。

項目 1回目(2025年11月) 2回目(2026年2月) 3回目(2026年5月)
心理的安全性 38.5 41.4(+2.9) 40.0(-1.4)
職務遂行上のサポート 42.8 41.4(-1.4) 43.3(+1.9)

心理的安全性の水準そのものは1回目の38.5より高いものの、最初に課題を見つけたときと同じ「サポートは高いのに心理的安全性は低い」という構図に戻る形になりました。 きれいな右肩上がりを期待していたので、この結果は少し残念でした。

ただ、この数字をどう受け取るかについては、いくつか前提を確認する必要がありました。

設問の変化

この間、サーベイ全体の設問構成が変わっていました。 経営や部門方針に関する項目が減り、代わりにキャリアや今後やりたいことに関する項目が増える、といった変化です。 回答時の意識に影響した可能性はありますが、心理的安全性のスコアにどの程度影響したかは判断できません。

メンバーの入れ替わり

2026年4月にチーム異動があり、2人が他のチームへ移り、1人が新しく加わって、8人から7人になりました。 3回目は、この構成になってはじめてのサーベイです。

7人規模のチームなので、1人の回答がスコアに与える影響は小さくありません。 実際、サーベイの振り返りでも「2人減って1人増えているので、前回との比較の正確性は落ちていると考えたほうがよい」という指摘がメンバーから出ていました。

1.4ポイントをどう見るか

下がったといっても1.4ポイントです。 「悪化した」と捉えるべきか、それとも見るほどの差ではないのか、正直なところ判断がつきませんでした。

前回の上昇が2.9ポイントだったので、それよりは小さい変化です。 ただ、回答者は7人で、統計的な検定をしているわけでもありません。 上下の幅を比べて「前回の上昇は本物で、今回の下降は誤差」と決めてしまうのは、都合のよい解釈になりかねないと感じました。

スコアの低下は、メンバーから話題に上らなかった

そして、振り返ってみると、これが一番の発見でした。

3回目の結果をチームで共有して議論したとき、心理的安全性の低下について言及したメンバーは、一人もいませんでした。 数字の上では下がっているのに、誰もそれを問題として持ち出さない。 この事実の受け取り方には、いくつかの可能性があると思っています。

  • 実際には困っていないので、話題にならなかった
  • 話題にするほどのことではないと各自が判断した
  • 変化が小さく、動きの大きい他の項目に比べて目に留まらなかった

ほかにも、まだ思いついていない理由があるかもしれません。 仮に二つめの「話題にするほどのことではないと各自が判断した」だとすれば、それはまさに私たちが下げたかったハードルの話そのものです。 どれにあたるのかは、スコアを眺めているだけでは分かりません。

次に何を観察するか

1.4ポイントの上下を追いかけても、この問いには答えられません。 そこで、次の二つを行おうと考えています。

心理的安全性について、こちらから問いを投げる

動きが小さい項目は流れてしまいがちです。 そこで次回のサーベイ確認時は、こちらから「相談しづらいと感じる場面はあるか」「質問をためらったことは最近あったか」と問いを投げてみます。 スコアの上下を報告し合うのではなく、スコアを対話のきっかけとして使う、という位置づけです。

感謝を伝える場を、作り直して再運用する

四つの施策のうち「週次で感謝や称賛を伝える場」は、その後いちど形骸化してしまいました。

そこでチームで話し、「感謝できることを探す過程を、そのまま週次の振り返りにする」という目的を置き直しました。 1週間のできごとから感謝できることを探し、その背景や、そこから得た学び、次のアクションを記載します。

主目的は振り返りに移りましたが、感謝できることを探すには、お互いの仕事に目を向ける必要があります。 そのため、お互いを知り、相談できる関係をつくるという当初の狙い、つまり心理的安全性の向上にも貢献する取り組みだと考えています。

今後は、この振り返りを続けることで、お互いの仕事への理解が深まったか、メンバー間の相談が増えたかを見ていきます。

おわりに

サーベイのスコアはチームの状態を判定する答えではなく、変化や違和感を捉えるためのセンサーとして扱うのがよさそうだと考えるようになりました。

実際、数字だけを見て「良くなった」「悪くなった」を決めようとすると、設問の変更やメンバーの入れ替わりといった前提に足をとられて、私たちの場合は結論を出しきれませんでした。

それでも、サーベイがなければ、心理的安全性について話し始めることは難しかったと思います。 スコアを起点に、違和感を見つけ、仮説を立て、施策を試し、効かなかったものを見直し、また観察する。 このサイクルをチームで回し続けられること自体が、スコアが何ポイント動いたかよりも価値があるのだと思っています。

なんでも相談チャンネルは、スコアの上下とは別に、日々の相談のしやすさを良くしてくれたという実感があります。 作り直した感謝の振り返りについては、まだ再開したばかりなので、これから変化を観察していきます。

私たちのチームを見ている限り、フルリモートでの心理的安全性は、放っておいて上がるものではないと感じています。 次のサーベイでは、スコアを報告し合うのではなく、そこから問いを立てるところから始めてみます。

同じようにフルリモートでチームづくりに悩んでいる方の、ヒントになれば幸いです。 ここまでお読みいただき、ありがとうございました。

数週間かかっていた gem バージョンアップの手動テストを Claude Code で自動化した話

はじめに

こんにちは。第一開発G アプリケーション基盤チームの寸田です。

アプリケーション基盤チームは複数のサービスにまたがる部分の開発を担っており、その中で私は主に Ruby / Rails のバージョンアップを担当しています。

シンクロ・フードでは全社的に業務における AI 活用を進めており、開発部でも今年から全エンジニアに Claude Code を配布しています。ただ「配って終わり」ではなく、活用ノウハウの共有や、日々の開発業務の中で AI でできそうなことは AI に任せるといった取り組みを継続して行っています。

その結果、Claude Code によって開発速度は上がった一方で、レビューやテストにかける時間が新たなボトルネックになるという変化が見えてきました。本記事では、こうした AI 活用の取り組みの一例として、特に負荷の大きかった gem バージョンアップの手動テスト を自動化した事例を紹介します。

開発フローを AI 前提で見直す

Claude Code の配布後、私たちはコードを書く工程だけでなく、レビュー・テスト・調査といった周辺工程も AI に任せられないかを順に検討してきました。その中でも費用対効果が大きいと判断したのが、長年エンジニアの手を取られてきた「手動テスト」の領域です。なかでも代表的なのが、gem バージョンアップに伴うテストでした。

なぜ gem バージョンアップのテストが辛いのか

弊社では主に Ruby / Rails を使ってサービス開発をしています。Ruby / Rails はバージョンの更新頻度が高く、それに追従するためには依存している多数の gem も合わせてバージョンを上げていく必要があります。

gem のバージョンアップは、RSpec による自動テストが通るだけでは「問題ない」と言い切れないケースがあります。代表例は次のとおりです。

  • 外部システムに依存する処理 … テストではモック・スタブしている部分が、本番の外部サービスとの組み合わせで初めて壊れることがある
  • 本番環境固有の挙動 … 本番特有の設定・データ・インフラ構成でしか再現しない問題があり、テスト環境では気づけない
  • JavaScript が絡む処理 … ブラウザ上での実際の動作は、リクエストスペックなどサーバーサイドのテストだけでは検証しづらい

例: CarrierWave のバージョンアップ

具体例として、ファイルアップロードに使っている CarrierWave gem のバージョンアップが挙げられます。

CarrierWave gem は、

  • Amazon S3 へのファイルアップロード
  • 画像の場合はリサイズ処理

などを担っています。つまり 外部システム(Amazon S3)に依存 しており、アップロードやリサイズが実際の環境で正しく動くかは、自動テストだけでは担保しづらく、結局は人手による動作確認に頼ることになります。

また、弊社特有の課題として、影響範囲が複数のサービスにまたがりやすい、という点もあります。弊社では共通機能を Rails エンジンとして社内 gem に切り出し、それを複数のアプリケーションから利用しています。そのため、ある gem のバージョンアップによる影響が複数のサービスに及びやすく、それぞれを担当するサービスチームをまたいでしまうことも珍しくありません。影響箇所をひとつひとつ手動でテストしていく必要があり、各サービスチームにテストを依頼してから完了するまでに数週間かかる こともあります。これが gem バージョンアップの最大の辛みでした。

手動テストの自動化

そこで、この手動テストを AI(Claude Code)で自動化することにしました。手動テストの実行基盤としては Playwright を採用し、Playwright のテストを Claude Code に書かせることにしました。バージョンアップする gem の利用箇所をソースコードから洗い出し、その箇所を確認する Playwright のテストを生成してもらう、という流れです。

ただ、単純に「ソースコードをもとにテストを書いて」と指示しただけでは、意味のないテストが生成されてしまうことが多くありました。たとえば、画面を開くだけで肝心の処理を通っていなかったり、確認したい機能とは関係のない操作をテストにしてしまったりして、「一見テストはあるが、肝心の箇所をまったく検証できていない」という状態になりがちだったのです。

そこで重要になるのが、テスト対象のコードがちゃんとテストされているかを AI 自身に確認させることです。具体的には、テスト実行時のカバレッジを計測し、テスト対象の箇所がカバーされているかを判断させています。なお、カバレッジの計測には coverband gem を利用しています。

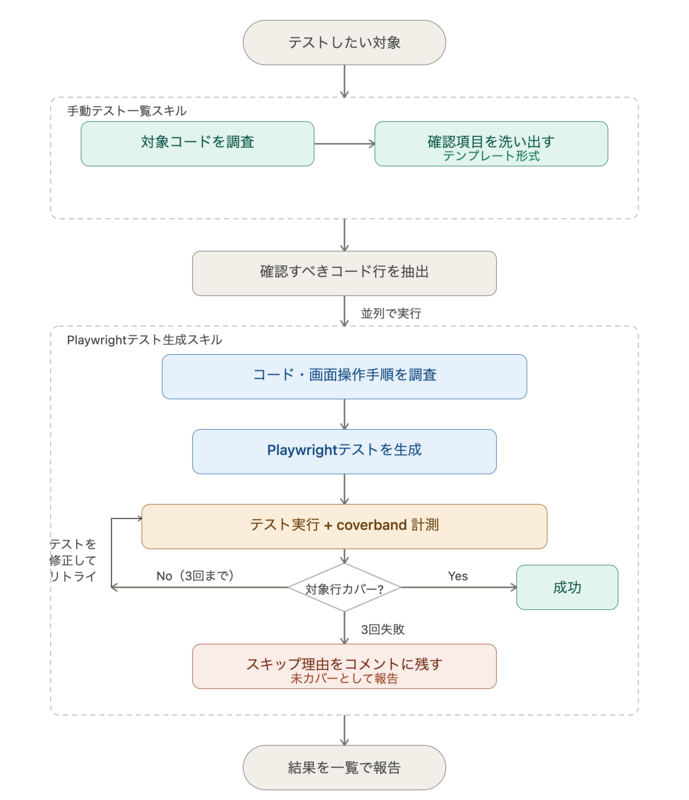
まとめると、以下のような手順でテストを追加しています。

  1. テスト対象(バージョンアップする gem の利用箇所)をソースコードから洗い出す
  2. テスト対象の Playwright のテストをコードから生成し、実行する
  3. カバレッジの計測結果を見て、ちゃんとテストでカバーされているかを確認する
  4. カバーされていない箇所のテストを修正する

どうしてもソースコードだけではテストを生成できない場合があるため、ステップ3〜4(カバレッジの確認と不足箇所の修正)は最大 3 回まで繰り返すようにしています。

スキルとして組み立てる

この一連の流れは、Claude Code のスキルとして実装しています。スキルは以下の3つから構成されています。

  • 手動テスト一覧を作るスキル … ソースコードを調査し、確認すべき項目をテンプレート形式で洗い出す
  • 1つの対象の Playwright のテストを生成するスキル … 指定された箇所をカバーするテストを生成し、実行 → カバレッジ検証 → 不足なら修正、というループを回す
  • オーケストレーターとなるスキル … 上記2つを束ね、対象をグループに分けて、テスト生成スキルを 複数エージェントで並列に 走らせる

処理の流れをフローチャートで示すと以下のようになります。

処理の流れのフローチャート

結果と課題

実際に CarrierWave gem のバージョンアップで試したところ、これまで手動でテストしていた多くの利用箇所を、自動化したテストでカバーできることが確認できました。一方で、現時点では AI が機能への到達方法を検出できず、カバーしきれないことがあります。この場合はソースコード以外のコンテキストを渡す必要があるようですが、こうした改善は今後の課題となります。

おわりに

今回は開発部における AI 活用の一例を紹介させていただきました。弊社ではこの他にも AI による生産性向上に取り組んでいます。 今回の記事が、AIでの開発生産性向上に取り組んでいる方々の参考になれば幸いです。

RubyKaigi2026に参加した弊社メンバーで感想を話し合いました

自己紹介

大津: 新卒4年目の大津です。Ruby歴は入社前のインターンから触り始めたので今年で5年目になります。RubyKaigiの参加は今回が初めてです。

岡塚: 新卒3年目の岡塚です。自分は入社してから触り始めたので今年でRuby歴3年目になります。自分もRubyKaigiの参加は今回が初めてです。

湯の川温泉近くの函館アリーナで行われました

印象に残ったセッション

From Formal Specification to Property Based Test

大津: まず自分が印象に残ったのは、「From Formal Specification to Property Based Test」という形式仕様をもとに、Property Based Testを半自動生成させる発表です。

岡塚: 形式仕様という概念が自分は初めて聞くものだったんですが、どういうものなんですか?

大津: 自然言語ではなく、形式仕様記述言語という論理的な記述が行える言語で記述した仕様のことです

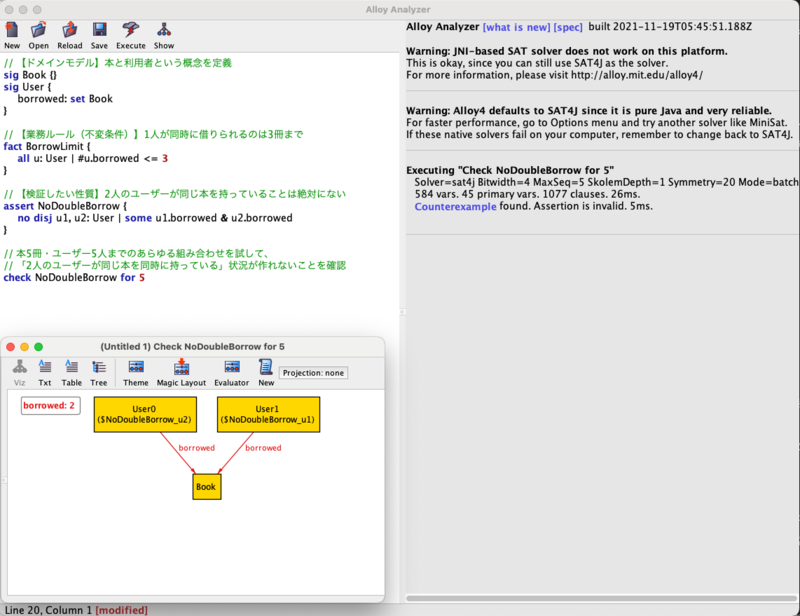
// 【ドメインモデル】 本と利用者という概念を定義
sig Book {}
sig User {
    borrowed: set Book
}

// 【業務ルール(不変条件)】 1人が同時に借りられるのは3冊まで
fact BorrowLimit {
    all u: User | #u.borrowed <= 3
}

// 【検証したい性質】 2人のユーザーが同じ本を持っていることは絶対にない
assert NoDoubleBorrow {
    no disj u1, u2: User | some u1.borrowed & u2.borrowed
}

// 本5冊・ユーザー5人までのあらゆる組み合わせを試して、
// 「2人のユーザーが同じ本を同時に持っている」状況が作れないことを確認
check NoDoubleBorrow for 5

岡塚: どのような場面で役に立つのでしょうか?

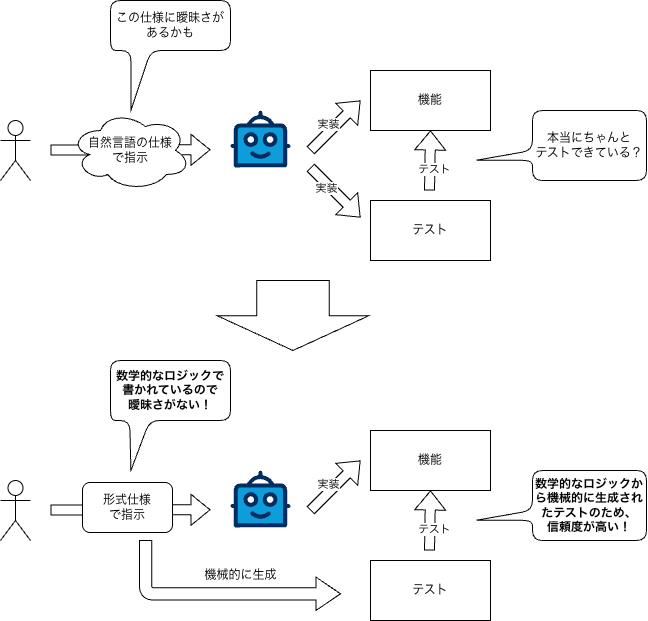
大津: 多くの現場でそうかと思いますが、自然言語でAIに指示をして、機能とテストを実装してもらうという流れが多いかと思います。
ただ、それだと自然言語自体の曖昧さが機能に悪影響を及ぼしてしまったり、AIが生成したテストが本当にちゃんとテストできているかという信頼性が担保できなくなってしまうという背景があります。
そこを形式仕様で指示することによって、自然言語のような曖昧さなくAIに指示ができる。そしてその形式仕様から機械的にテストを生成することで、信頼性の高いテストが作れるから嬉しいよね、という発表でした。

上記について大津による略図

岡塚: 実現できたら確かにテストとしてすごく理想的で革新的だなという感想を持ちました。
大津さんは形式仕様というものについて既にご存知だったとお聞きしたんですけれど、どのような場面で使いましたか?

大津: 複雑な仕様の改修をする機会があり、変更内容が他の箇所に影響しないか事前に確認したい場面がありました。

なので形式仕様を使えば、そのようなところで出るバグが防げるんじゃないかと思って、試験的に導入してみたことがありました。現在も形式仕様で検証を行い、改善ポイントについて事業部と議論している段階です。とても便利ですよ。

岡塚: あ、もうそこまで使われているんですね。確かにそうですね。すごい複雑なドメインみたいなのって、サービスでもありがちというか、自分が普段触っているサービスもそういうところで使えるところを今聞いていてあったりするかな、と思ったりしていたので、ちょっと触ってみたいなって思いましたね。

大津: Alloyは導入も便利なんですよ。VS Codeの拡張機能があって、VS Codeでコードを書いて、その拡張機能を入れればビジュアライザーが出てくるので、別途インストールとかもいらず、すごい楽です。

先程のコード例を実行して実際に反例が出てくる様子

岡塚: あ、そうなんですね。いいですね。ちょっと後で触ってみようと思います。

大津: AIを使ったりもしたんですけど、自分が試した範囲ではAIもAlloyのコードを十分書いてくれますね。参入障壁は比較的低いと思います。ぜひ使ってみてください。

岡塚: 分かりました。ありがとうございます。

The Journey of Box Building

大津: もう1個印象に残ったのが「The Journey of Box Building」ですね。

岡塚: どのような発表でしたか?

大津: Ruby 4.0から実験的機能として導入されているRuby Boxについてのお話でした。Ruby Boxはどういうものかというと、複数のバージョンのgemや機能を別々のRuby Boxという箱のようなものに入れておき、呼び出し側で特定のRuby Boxを選んで実行するというものでした。

岡塚: どのような場面で役に立つのでしょうか?

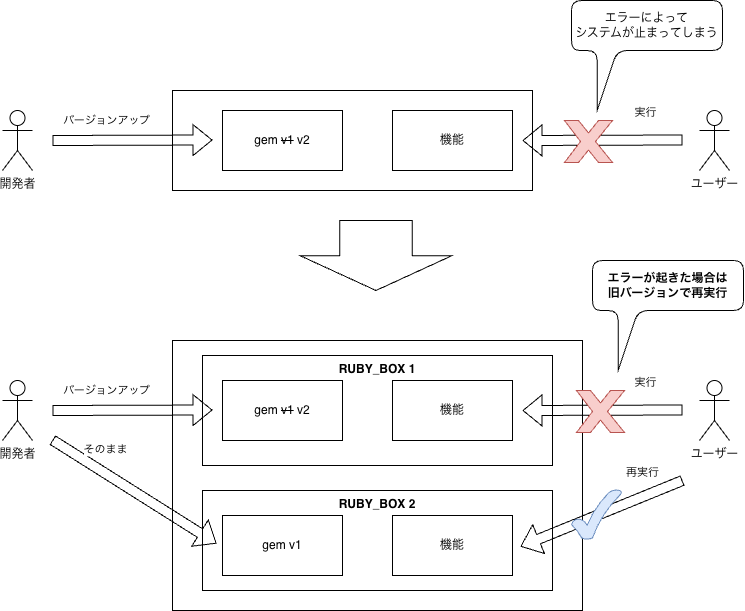
大津: 例えばgemのバージョンアップでは、仕様変更による予期せぬエラーが懸念されると思います。それをRuby Boxという機能で防ぐという使い方が紹介されていました。

例えば、Ruby Box 1番にアップデートしたバージョンのgemと機能を入れておいて、Ruby Box 2番に元のバージョンのgemと機能を入れておくというふうにすると、Ruby Box 1番のアップデートした側で実行して失敗したときに、Ruby Box 2番の処理にフォールバックさせるといった切り替えをアプリケーション側で組むことで、安全に本番デプロイができるというような使い方が紹介されていました。

上記についての大津による略図

岡塚: Ruby Boxは以前から気になっていて、面白そうだなって思っていました。ライブラリの開発のための機能がメインなのかなとか思っていたんですけれど、Railsでも使える場面がありそうですね。
他の使い方はありますか?

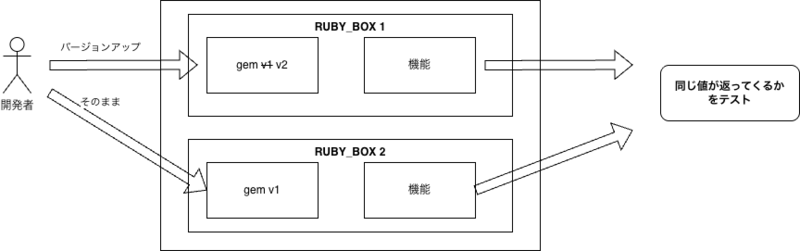
大津: もう一つ面白いと思ったのが、さっき言ったRuby Box 1番、Ruby Box 2番を、本当にデプロイいきなりするのがちょっと怖いなとなったときに、Ruby Box 1番とRuby Box 2番が同じ値を返してくるかというテストを、1つの環境上でできるというところですね。ここはかなり面白いなと思いました。

上記についての大津による略図

岡塚: 社内で使えそうなところもありそうですね。

大津: そうですよね。gemのバージョンアップだけでなくRailsのバージョンアップなどでも使えそうだなと思いました。

岡塚: でもちょっとこれをやるためには、Ruby 4系まで上げる必要があるので、ちょっと先ですけれども。

大津: はい、そうですね笑

The AST Galaxy to the Virtual Machine Blues

岡塚: では、続けて私が興味を持った発表について話します。「The AST Galaxy to the Virtual Machine Blues」(https://atdot.net/~ko1/activities/2026_rubykaigi2026.pdf)についてなのですが、YARVを作った本人の笹田さんが、AST(Rubyのコードを構文解析した結果であるデータ構造)の直接実行の話をされるというところが面白そうだなと思い聞きに行きました。

大津: 発表スライドを拝見したんですが、今言語処理系が高速化とともに複雑化しているという問題があって、それをシンプルなまま高速化するというのは、メンテナンスなどの面で嬉しそうかなと思いましたね。岡塚さんはもともとVMに興味があって、この発表を聞いたんですか?

岡塚: そうですね。Rubyの言語処理系については興味があったもののVMがどう動いているかなどをあまり知らず、その辺りを少し知ることができればいいのかなというのがRubyKaigiに行ったモチベーションの一つではあったという気持ちでした。そしたら、YARV自体を作った人が、それについて再考するというような趣旨の発表をするというところを知ってとてもびっくりして、何の話をするのだろうと思い見に行きました。

大津: そうなんですね。岡塚さんはVMの方に興味があるとのことでしたが、今回の発表ではRuby1.9でVMが入る前のASTの直接実行に完全に戻る...という訳ではないものの、現代的な技術を使ってRuby1.9以前に似て非なることをするという感じなのですかね。

岡塚: おそらくそうなんじゃないかと思っています。

大津: なかなか難しそうな発表ですよね。

岡塚: 難易度が高い内容で、すべてを理解するには更なる学習が必要だと感じました。

大津: そうですよね。構文木からVMのバイトコードへの変換を飛ばして機械語に、というのは仕事では全然触れない範囲だと思うので、こういう発表で知れるのがいいですよね。

岡塚: そうですね。なんとかして、この辺のAST周りの話を追っていきたいなとは思うんですけれど。

大津: ぜひ来年もRubyKaigiに参加して、追っていきたいですね。

岡塚: この発表についてではないのですが、全体的に、数年前のRubyKaigiでの発表の続編のような印象のものが多かったですね。

大津: そうですね。今後もRubyKaigiに参加したりして、話にキャッチアップしていけるようになりたいですね。

岡塚: ですね。じゃあ、次行きますね。

Surviving Black Friday: 329 billion requests with Falcon!

岡塚: 「Surviving Black Friday: 329 billion requests with Falcon!」というセッションについてです。Black Fridayというのは、アメリカの感謝祭の翌日にあたり、オンラインショッピングのリクエスト数などが急増するシーズンらしいです。
そこに対応するにあたって、もともとUnicornを使っていたサーバーを独自の別サーバーであるFalconに置き換えるということをやっていたようで、独自開発したものに置き換えてしまうというところに技術力の高さを感じました。

大津: なるほど。

岡塚: 置き換えたところのサーバーであるFalcon自体についても興味深いと思っていたのですが、それ以上にためになったのが試行錯誤の過程の話です。サーバーを作って一気にデプロイしたかというとそうではなかったようで、致命的なものも含めて幾つかの不具合が潜むリスクがあったようでした。
そこをカナリアリリースやスケールテストを組み合わせてどうやって段階的に移行していくのかというような試行錯誤の部分の話があって、そこが興味深いと感じました。

大津: スライドを見ていてすごいハラハラする発表でした。だんだんBlack Fridayが近づいていく中でいろんなエラーが出て、解消しているという、間に合うのかというハラハラ感がすごいある発表かなと思ったんですが、会場の雰囲気はどうでしたか?

岡塚: 盛り上がっていたような気がします。発表の最後の方で、Black Fridayに実際に問題なくアクセスがさばけてましたという話があったのですが、その部分では会場からおおっ、と歓声が上がったりしていた気がします。

大津: これは達成感ありそうですよね。こんなすごい苦労して、結構改善していますからね。

岡塚: そうですね。席が全部埋まっていて立ち見になっているくらいの状態で、雰囲気盛り上がっていた感じでした。

大津: 人気の発表だったんですね。

岡塚: そうでした。

大津: 自分と岡塚さんのチームだとなかなかこういう大きいリリースあんまりないかなと思うんですが、活かせそうなところありましたか?

岡塚: 活かせそうなところがあるかと言われると、パッとは出てこないかもしれないです。でもそうですね、UnicornのサーバーをPumaに移行するタイミングなどで、事故の確率を最小にするためにどのように移行するか、という観点で活かせるかなと思っています。

大津: そうですね。移行してすごく遅くなってしまったなどになったら困りますからね...ちゃんとこの発表のように、計画を立てて監視して、対策を打って、というサイクルをちゃんと繰り返したいですね。

Ruby Releases Ruby

岡塚: 最後に紹介するのは「Ruby Releases Ruby」というセッションです。Rubyが普段どのように開発されているのかというのは本当に意識したことがなく、Rubyに詳しい方々がさまざまな取り組みをされているのだろう、という程度の認識でした。CIのサイクルの回し方、複数プラットフォームの動作担保、リリース速度向上の取り組みなど、開発の裏側を知れる内容で、ワクワクしました。

大津: このKeynoteは自分も現場で見ましたが、面白かったです。いろんなコミッターの関わり、関係性が見えて面白かったですね。

岡塚: そうですね。

大津: これについてうちの会社の場合にどのように活かせるかについて考えていたのですが、社内ツールなどで自動化され切れていない部分で活かせる気がしています。対応時に緊張するし、間違えたらどうしようみたいな。そういうのをCIとかでリリース、自動化できるとすごい嬉しそうですよね。

岡塚: 確かにそれはありそうですね。

大津: 今だと開発内容がリリースされた後に、営業部の方にリリースしましたっていうふうにSlackなどでお伝えいただいているんですけど、この辺も自動化できるかもですね。もう時代は自動化の時代ですからね。

岡塚: できたら業務チームの負担も減るのでいいですよね。以前だと自分の場合、ちょっと自動化したいと思いつつやる作業が面倒に感じていたのですが、今だとAIを使ってすぐにプログラムを書けるので、自動化に取り組むモチベーションは相対的に上がっています。

大津: そうですよね。なんなら、開発以外のメンバーでも、AIを使って自動化していますもんね。

岡塚: そうですね。そんな話もありましたね。

大津: 負けてられないですね。

岡塚: 頑張らないと。

大津: そんな感じですかね。

岡塚: はい!ありがとうございました。

RubyKaigi全体についての感想

大津: 最初は英語が理解できるのか、技術的な内容についていけるのか不安でした。しかし、Google翻訳の会話機能でのリアルタイム翻訳を使ったり、分からない単語が出てきたらすぐにAIに聞いたりすることで、問題なく楽しむことができました。セッション以外のイベントでも、新機能の使い道について話し合ったり、登壇者の方に詳しい内部実装をお聞きできたりと、実際に会場に行かないと受けられない刺激を受けることができました。

岡塚: 最初は『セッションはネットでも見られるし、現地で見ても楽しい程度かな』という気持ちでした。しかし、実際に行ってみると熱量や雰囲気が直に伝わってきて、かなり刺激になりました。

おわりに

一緒に参加した弊社メンバーと感想を話し合うことで、お互いに印象に残ったセッションや着眼点が違っていたことに気づき、一人で参加するよりも何倍も学びが深まったように感じます。
RubyKaigiのオーガナイザーの方々や、発表者の皆さんへの感謝でこの記事を締めたいと思います。
来年のRubyKaigi2027は宮崎県での開催だそうですね。非常に楽しみです!

複数DB間環境のRailsアプリのCIを自社版database_rewinderで(ちょっとだけ)速くする

はじめに

こんにちは、第二開発Gの岡塚(https://x.com/kyuuri1791)です。 前回エンジニアブログの記事を書いた時は第三開発Gに所属だったのですが、その後異動になって1年くらい経っています。時間が経つのが早い......
今のチームではモビマル店舗物件探しの開発をしていることが多いです。
今回は、普段自分が業務でやっている開発とは全く関係ないのですが、社内で使っているデータベースクリーナーを自作版に置き換えてちょっとだけCIが速くなったのでその話を書きます。

背景

本題に入る前に、社内の事情関係で若干ハイコンテキストな部分があるのでそこについての説明を書きます。
弊社のDB構成としては、1個の物理的なDBの中に複数の論理的なDBが配置されている構成になっています。レプリケーションしてR/W splittingするなどではなく、複数サービスがあってそれぞれでのDBが置かれているマルチテナンシー(?)構成です。
直近に立ち上げられたアプリケーションについては1サービス1DBに閉じる世界観で、もし別DBを触りたい場合はAPIなりなんなりを用意してデータを取りに行くような構成になっているのですが、昔から開発されているサービスに関しては歴史的な経緯から複数DB間でアソシエーションが貼られており、joinが発生するような状態になっています。

本題

ここからが本題です。
複数DB間でjoinする状態があるといろいろと困ることが出てくるのですが、その中の一つとしてCIの実行時間の問題があります。
RSpecでは特に理由がなければuse_transactional_fixtures=trueにしてトランザクショナルにテストを実行すると思います。(たぶん...)
が、複数DBに対してはdatabase.ymlでそれぞれでコネクションを作ってみにいくことになるので、use_transactional_fixtures=trueにして、

  1. コネクションAでdb1に対してなんらかのレコードを作成
  2. コネクションBでdb2に対してなんらかのレコードを作成
  3. 1と2で作ったレコードをjoinするコードをRSpecで実行する

とした場合コミット前なのでコネクション間でデータを互いに参照できず、3を行うようなRSpecがコケまくるという状態になってしまいます。そのため、

  • use_transactional_fixtures=falseにする(これによりRSpecがちょっと遅くなる)
  • database_rewinderの複数DB機能を使ってデータをクリーンアップする

という形に既存でなっていました。

考えたこと

これでCIが遅くなっているのはちょっとイヤだったので、なんとかして速くしたいなと思いました。やり方としては、いくつかありそうです。

  • Railsにモンキーパッチを当てて、CIでは無理やりコネクションを一つにする
  • CIではトランザクション分離レベルをread uncommittedに落とす
  • なんとかしてデータのクリーンアップ部分を高速化する

箇条書き1個目はやってみて挫折しました。箇条書き2個目は正直一番手っ取り早いですが、ちょっと怖いです。
箇条書き3個目はどうだろう...?と考えてみます。RSpecの実行ログを眺めていたところ、以下のようなログが流れていました。

delete from A.t1; delete from A.t2;
delete from B.t3;

database_rewinderのREADMEを見ると、

Also, database_rewinder joins all DELETE SQL statements and casts it in one DB server call.

と書いてあったので、ぱっと見だとdeleteは1リクエストでいいように思います。内部実装を読んでみると、1DBに対してcleaner的なクラスのオブジェクトが1個ずつ作られて、それぞれの単位でdeleteをまとめて発行しているみたいでした。multiple databasesといった場合それぞれでjoinが発生しているなどということは普通想定しないような気がするので、しかしそれはそうという気がします。それはそれとして、

delete from A.t1; delete from A.t2; delete from B.t3;

みたいにdelete文を1リクエストにまとめるようにすれば若干速くなりそうです。

実装

以下のようなスクリプトを書いてみました。

# frozen_string_literal: true

class MysqlSynchroDbRewinder
  class << self
    def init(conf = { host: '127.0.0.1',
                      username: 'dummy_user',
                      password: 'dummy_password' },
             logger = Rails.logger)
      @affected_tables = Set.new
      @logger = logger
      @cleaner_client = Mysql2::Client.new(
        **conf,
        flags: Mysql2::Client::MULTI_STATEMENTS,
        reconnect: true,
        init_command: 'SET FOREIGN_KEY_CHECKS = 0;SET UNIQUE_CHECKS = 0;',
      )

      # mysql2 経由で実行されたクエリは
      # - Mysql2::Client#query を通過する
      # - Mysql2::Client#prepare -> Mysql2::Statement#execute を通過する(prepared statementとして実行される)
      # の2つがありうるため両方をフックする
      # @note
      #  このコードを書いた現時点でのRails最新である8.1ではMySQL adapter限定でprepared statementがデフォルトで無効になっている
      #  なのでprepared statement用のprependをしなくても当分は困ることはない気もする(明示的にdatabase.ymlでprepared_statements: trueにしない限り)が対応しておく
      #  元々は7.2でデフォルトを有効にする予定だったが、既存のバグ周りで一悶着あってリバートされているという経緯らしい(https://github.com/rails/rails/pull/48370)
      raise '.init has already been called. Do not call init twice.' if Mysql2::Client <= Mysql2ClientSynchroDbExt

      Mysql2::Client.prepend(Mysql2ClientSynchroDbExt)
      Mysql2::Statement.prepend(Mysql2StatementSynchroDbExt)
    end

    # @param [Mysql2::Client] client
    # @param [String] sql
    def track_insert(client, sql)
      match = sql.match(/\A\s*INSERT(?:\s+IGNORE)?(?:\s+INTO)?\s+(?:\.*[`"]?([^.\s`"(]+)[`"]?)*/i)
      return unless match

      @affected_tables << "#{client.query_options[:database]}.#{match[1]}"
    end

    def clean!
      return if @affected_tables.empty?

      # 念の為100件ずつに分割して処理(max_allowed_packet対策)
      if @affected_tables.size > 100
        @logger.warn 'affected tables to clean has exceeded 100. you might be excessively inserting data in tests.'
      end
      @affected_tables.each_slice(100) do |tables_chunk|
        statements = tables_chunk.map { |t| "DELETE FROM #{t}" }.join(';')
        # トランザクションで囲むことでディスクへのfsync頻度を最小化し、IO待ち時間を減らす
        full_query = "START TRANSACTION;#{statements};COMMIT;"
        @cleaner_client.query(full_query)
        while @cleaner_client.next_result; end
        @logger.info(full_query)
      end

      @affected_tables.clear
    end
  end
end

module Mysql2ClientSynchroDbExt
  def query(sql, options = {})
    result = super(sql, options)
    MysqlSynchroDbRewinder.track_insert(self, sql) if affected_rows > 0 && sql.match?(/\A\s*INSERT/i)
    result
  end

  def prepare(sql)
    statement = super(sql)
    statement.instance_variable_set(:@_rewinder_sql, sql)
    statement.instance_variable_set(:@_rewinder_client, self)
    statement
  end
end

module Mysql2StatementSynchroDbExt
  def execute(*args)
    result = super(*args)
    sql = instance_variable_get(:@_rewinder_sql)
    client = instance_variable_get(:@_rewinder_client)
    if sql && client && (affected_rows > 0 && sql.match?(/\A\s*INSERT/i))
      MysqlSynchroDbRewinder.track_insert(client, sql)
    end
    result
  end
end

コードについてちょっと補足すると、Mysql2レベルでパッチを当てて、複数DBに対して発行されたinsertクエリを全部収集しています。使う側はdatabase_rewinderと同じノリで、RSpecのrails_helper.rbなどで以下のように指定します。

  config.before(:suite) do
    MysqlSynchroDbRewinder.init
  end

  config.after do
    MysqlSynchroDbRewinder.clean!
  end

これを複数DB間joinが起きているアプリケーションに対して入れたところ、最大で10%くらいCIが速くなりました。複数DB間joinが頻繁に起きているアプリケーションほど効果があり、あまり起きていないアプリケーションではそこまで効果がない。逆にCIが遅くなってしまっているということはなさそう、という感じです。

終わり

無事動いてくれるかなと思いながらマージしたのですが、導入してみて1ヶ月ちょい経っていて、現状特に問題なくCIで安定して動いてくれていそうだったので一旦よかったです。
こちらの記事が、どなたかの参考になれば幸いです。
ここまでお読みいただき、ありがとうございました。

AWS WAF レートリミット導入と誤検知対策:正規トラフィックを保護するアーキテクチャを設計した話

はじめに

こんにちは。開発部 SRE チームの柴山です。
技術構成の記事でもご紹介した通り、弊社ではWebアプリケーションの脆弱性保護を目的として Scutum を中心としたセキュリティ対策を実施してきました。
しかし、昨今のAI技術の急速な発展に伴い、悪意のある攻撃だけでなく、データ取得(AI学習等)を目的とした突発的なスクレイピングといった「予測不可能なトラフィックスパイク」に直面することが増えてきました。
これらはバックエンドのリソース逼迫を招き、正規のユーザー様にも影響を与えかねません。
こういった機械的なアクセスには、アクセス数を制限するレートリミットを設定するのが定石として挙げられますが、導入には様々な検討事項があり、単純に導入するだけでは誤検知によって正規のトラフィックさえも巻き添えにしてしまうリスクがあります。
インフラを保護できても、正規ユーザーまでブロックして機会損失を生んでしまっては本末転倒です。

弊社では「正規トラフィックを保護するためのアーキテクチャ設計」として、最終的に AWS WAF を採用しました。
本記事では、その採用に至った経緯や設計思想についてご紹介いたします。

技術選定

突発的なトラフィックスパイクを制御するにあたり、まずは「どこで制限をかけるか」という実装ポイントの比較検討を行いました。
弊社ではWebサーバー(Nginx) + AWS ALBという構成で、サービスを提供しています。導入のしやすさから、以下二つのアプローチを比較検討しました。

  1. マネージドサービスでの制御(AWS WAF の レートベース ルールステートメント)
  2. サーバーサイドでの制御(Nginx の limit_req + geo モジュール)

それぞれの特性と優位性について、弊社での運用環境をもとに評価した結果がこちらです。

評価軸 AWS WAF Nginx
初期リソースコスト △ 中 ◎ 低
運用保守コスト ◎ ほぼゼロ(フルマネージド) △ 運用保守のフローを要検討
GeoIP/Bot DB更新 ◯ 自動 △ 手動(要自前構築・保守)
導入時の安全性 (DryRun) ◎ 可能 (Countモード) △ 工夫が必要(OSS版)
DDoS対応 ◯ 優位(専用ルール有/一時的な適用が可能) △ 困難(分散型は対応不可)
ログの可視性 ◯ 優位(専用ダッシュボード/Log ツール連携) △ 自前構築(ログ転送・別途可視化のコストが発生)

表からもわかる通り、初期のリソースコスト面では Nginx に分がありますが、保守・運用の観点で AWS WAF が弊社の要件にマッチしていました。
その中でも以下の点は非常にメリットとして大きく、採用の決め手となりました。

  • フルマネージドの恩恵
    GeoIP データベースやBotリストを都度更新し続けるのは長期的に人的な運用コストがかかることになります。
    ここをAWS側にほぼ丸投げできるのは大きなメリットの一つです。
  • Countモードによる段階的導入
    表題通り、今回一番懸念していた点が正規ユーザーの誤ブロックです。
    AWS WAF にはブロックせずにルール評価だけを行う Countモード が存在するため、事前にルールの妥当性を精度高く検証することができます。

設計の壁

いざ、AWS WAF でレートリミットを導入しようと思いましたが、早速いくつかの壁にぶつかりました。
「どうやって閾値を決定しよう」「正規ユーザーの誤ブロックを防ぐには?」「これって一律に制限かけていいの?」
たとえば、レートリミットの閾値を「1IPアドレスあたり、5分間に100リクエストまで」と決め打ちしたとします。
それだけで単純に適用をすると、以下のような絶対に弾いてはいけない正規のトラフィックまで遮断してしまいます。

  • 優良Bot(クローラー): Googlebot 等の検索エンジンや外部連携先の巡回Bot
  • 正規ユーザーアクセス: 本命の絶対にブロックしてはいけないトラフィック
  • アプリ・サービス連携: 外部連携サービスからのWebhookや、自社アプリなどからの通信
  • 監視系: 外形監視など

これらのトラフィックを踏まえた上で、悪意のあるトラフィックだけをそぎ落とし、可能な限り正規のトラフィックを通す必要がありました。

アーキテクチャ

今回の肝である誤検知の対策として、フラットにレートリミットをかけるのではなく WAF の評価順位の仕様を利用した多段フィルターを設計しました。
AWS WAF は設定された優先順位(Priority)の小さい順にルールが評価されていきます。
全ての通信に対してフラットにレートリミットをかけるのではなく、「既知の脅威をブロック」->「正規トラフィックの救済」->「その他トラフィックへのレートリミット」という段階的にふるいへかけるアーキテクチャを構築しました。

  1. 前段フィルター: 既知の脅威をブロック
    最前段では明らかに不正なトラフィックをAWSが提供するマネージドルールなどを用いて遮断します。

  2. 中段バイパス: 正規トラフィックの保護
    ここが正規トラフィック保護の要になります。
    前段を通過したトラフィックに対して、前述した項目(優良Bot、アプリ・サービス連携、監視系等)を独自の複合的な条件で識別を行います。
    条件に合致した場合は Allow(明示的な許可)とし、この段階で以降のルール評価をスキップさせてバックエンドへのトラフィックを許可します。
    ここに引き算のルールを挟むことにより、死守すべき正規トラフィックが後段のレートリミットにかかることを防ぎます。

  3. 後段フィルター: レートリミットの適用
    最終的に残ったトラフィックの大量アクセスにのみレートリミットを適用します。
    ルールステートメントにより、特定の属性を持つ通信が閾値を超えた場合にのみ遮断をすることができます。

誤検知を防ぐための Tips

静的ファイルの考慮
Webページへの初回アクセス時、ブラウザはページにリンクされた大量の静的ファイル(画像、CSS、JS等)を同時にリクエストします。
これをレートリミットのカウントに含めると、正常なユーザーでも一瞬で閾値に達してしまうリスクがあります。
これらを考慮した閾値を設定するか、静的ファイルはCDN等でキャッシュさせて、静的ファイルをカウント対象外にすることが重要です。

閾値の決定について
レートリミットの閾値を「だいたい1分間にn回くらいだろう」と勘で決めるのは非常に危険です。
過去のアクセスログを分析し、以下のようなステップで閾値を決定しました。一例として共有させていただきます。

  1. 外れ値を除外してベースとなる値の算出
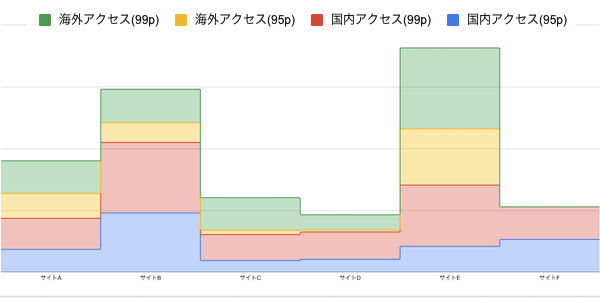
    まずサービスのアクセスログから各時間(分)あたりで上限の基準値として95パーセンタイルを抽出しました。
    分析対象のログにはすでに悪意のあるアクセスやスクレイピングなど異常なスパイク(外れ値)が含まれていました。
    そのまま最大値を基準にしてしまうと、閾値がかなり甘めに出てしまうことになります。
    外れ値除外の例
    上位5%のノイズを取り除くことによって、Botなどによる外れ値を極力排除した値を抽出することができました。

  2. 安全係数の適用と基準値の厳格化
    抽出したベース値に対し、トラフィックの属性(エンドポイント等)ごとに数値を比較し、より厳格な(小さい)値を採用しました。
    その上で、正常な突発的アクセスを許容して安全側に寄せるため、安全係数(1.x)を掛け合わせて最終的な閾値を決定しています。
    これにより、正規トラフィックの多少の突発的なアクセスは許容しつつ、Botによる攻撃だけを制限するような閾値を導き出すことができました。

導入

アーキテクチャと閾値の設計が完了し、いよいよ導入フェーズですが、いきなり本番環境で遮断を開始するのは危険です。
いくら念入りに計算をしていても、あくまで絵に描いた餅で正規トラフィックの誤ブロックリスクは依然として存在します。
そこで、技術選定の項で紹介したCountモードを活用し、以下のような4段階のフェーズに分けて慎重にリリースを行いました。

フェーズ 環境 モード 実施内容のハイライト
フェーズ1 テスト環境 Count -> Block IaC(Terraform)でのインフラ構築と、テストシナリオに基づく動作(遮断)検証。
フェーズ2 ステージング環境 Block 本番同等環境でのリハーサル。
正規系動作の確認と、意図した通信のみが遮断されるかの最終確認。
フェーズ3 本番環境 Count 【最重要】 本番環境へCountモードで適用。
およそ二週間かけて全曜日・時間帯の実際のトラフィックログを取得・精査し、机上の計算とズレがないかを確認
フェーズ4 本番環境 Block ログ精査で正規トラフィックの巻き込みがないことを確信した後、本番運用(Block)へ切り替え。

このリリース計画の中で最も重要なのが フェーズ3(本番環境でのCount運用) になります。
本番のトラフィックがWAFに流れ、CloudWatch Logs に出力された検出結果を2週間かけて分析しました。
ここでは「正規ユーザーを誤って検出してしまっていないか」「正常にレートリミットが効いているか」「連携や監視に考慮漏れの項目が無いか」の答え合わせを実施しました。
結果として、設計時には検討できていなかった「優良Bot」や「連携系のアクセス」、「状況に応じて遮断されてしまう正規ユーザー」の存在に気づくことができました。
もし最初からBlockモードで導入していた場合、これらの通信も遮断してしまい、サービス影響に繋がっていた可能性があります。

誤検知の可能性を事前に全て摘み取ることで、満を持して最終フェーズのBlockモードへの切り替えを実施しました。
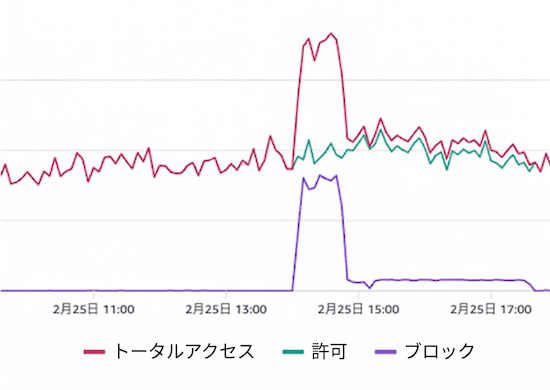
その成果が、導入後に発生した突発的な大量アクセス時のメトリクスに表れました。

実際の検知事例

上記グラフの通り、トータルアクセス(赤線)が急増した際、レートリミットが即座に反応し、悪質なトラフィックのみを選択的にブロック(紫線)してくれています。
一方で、正規ユーザーの通信(緑線)はスパイクの影響を一切受けることなく一定に保たれていることが見て取れます。
無事、正常なトラフィックを保護したまま、悪質なトラフィックのみを遮断するレートリミット環境を本番稼働させることに成功しました。

まとめ

今回は、AWS WAFを用いたレートリミットの導入と、正規トラフィックを保護するためのアーキテクチャ設計についてご紹介しました。
単に「アクセスを一定数でブロックする」という安易な設定をせず、以下のステップを踏むことで、「正規トラフィックを保護するアーキテクチャの設計」を実現できました。

  1. アーキテクチャの工夫: WAFのPriority仕様を活用した「段階的なフィルター」と、静的ファイルの考慮。
  2. 統計に基づいた閾値設計: 勘に頼らず、過去のアクセスログのp95値から算出した「ノイズを極力排除した閾値」の決定。
  3. 安全なリリース戦略: 本番環境でのCountモード運用と、ログ精査による誤検知の事前排除。

Scutumに加えてAWS WAFを導入したことで、より堅牢な構成を実現できました。
細かなチューニング内容や今後の展望があれば、またこの場でご紹介させていただけたらと思います。
この記事が、もし今後レートリミットを導入しようと検討されている方の参考になれば幸いです。

AppsFlyerのUDLを使ったディファードディープリンク実装で学んだこと

シンクロ・フード開発部モバイルアプリチームの横山です。
普段は、飲食店と飲食店で働きたい求職者を繋ぐ「求人飲食店ドットコム」アプリのAndroid開発を担当しています。

今回は、アプリにディファードディープリンクを実装した経緯と、調査・設計・実装を通じて得た知見をまとめます。同じような機能を検討している方の参考になれば幸いです。

実装の背景

弊社アプリではすでにUniversal Links(iOS)とApp Links(Android)によるディープリンクを実装していましたが、これらはアプリがインストール済みのユーザーにしか機能しないという制約があります。リンクを踏んだ時点でアプリが入っていなければ、Webページへのフォールバックで終わってしまいます。

今回、求人飲食店ドットコムの求人詳細画面に「アプリで開く」ボタンを追加することになりました。このボタンはアプリをインストールしていないユーザーにも利用してもらう想定です。 つまり、「未インストールのユーザーをApp Store / Google Playへ誘導し、インストール後に目的の画面へ遷移させる」 という仕組みが必要でした。この課題を解決するのがディファードディープリンクです。

ディファードディープリンク

ディープリンクの種類と選定理由

ひとくちに「ディープリンク」といっても、実装方式はいくつかに分類されます。

  • Custom URL Schememyapp://path のようなカスタムスキームでアプリを起動する方式です。シンプルな反面、アプリが未インストールの場合はエラーになるためユーザー体験上の課題があります。また、同じスキームを別のアプリが乗っ取れてしまう「URLスキームハイジャック」のような脆弱性もあり、現在は積極的に使われるケースは少なくなっています。

  • Universal Links(iOS)/ App Links(Android):通常の https:// URLでアプリを起動できるOSレベルの仕組みです。アプリ未インストール時はそのままWebページとして開くため自然なフォールバックが実現でき、現在のスタンダードといえます。弊社アプリもこの方式をすでに導入していました。

  • サードパーティ製SDK(AppsFlyer / Adjust等):SDKが提供するリンク機能を利用する方式です。ディープリンクとしての機能に加えて、インストール前後の計測やアトリビューションにも対応しており、マーケティング施策と連携しやすいのが特徴です。今回はもともとAppsFlyerのOneLinkを利用していたため、AppsFlyerが提供するUDL(Unified Deep Linking)を採用する方針となりました。

UDL(Unified Deep Linking)とは

UDLはAppsFlyerが提供するディープリンク取得APIで、従来は別々のコールバックで制御していた「Direct Deep Linking」と「Deferred Deep Linking」のAPIを、1つのインターフェースに統合した仕組みのようです。

  • Direct Deep Linkingは、アプリがすでにインストールされている状態でリンクから起動するケースです。
  • Deferred Deep Linkingは、未インストールの状態でリンクを踏んだユーザーがストアからインストールし、初回起動した際に遷移先を復元するケースです。コールバックはアプリ起動後に非同期で返ってくるため、「いつデータが返ってくるか」というタイミングの揺らぎへの対応が、実装上の重要な課題となります。

UDLの調査

UDLはSDKの初期化とともにコールバックを購読し、非同期でパラメータを取得する仕組みです。そのため、「いつデータが返ってくるか」というタイミングの揺らぎを考慮し、実装前に以下のユースケースに沿って挙動を検証しました。

  • パラメータの伝搬: リンクに付与した情報がストア経由でも欠落せずに受け取れるか、また Direct / Deferred で受け取れる値に差異がないか
  • コールバックのタイミング: Direct / Deferred でそれぞれで、どのタイミングでデータが返ってくるか
  • 「15分制約」の挙動: インストールから起動までのタイムリミットがどの程度厳密に運用されているか

調査を通じて浮き彫りになった課題は、「コールバックの即時性は必ずしも保証されない」という点でした。ネットワーク環境や端末の状態によって、数秒以内にデータが取得できることもあれば、タイムアウトで情報が返ってこないケースの可能性もあるようでした。このため、実装側では「情報が取得できなかった場合」を前提としたハンドリングが必須ということが分かりました。

また、実機検証の結果、ストアを経由する際(Deferred)には利用できるパラメータに制約があることも分かりました。 取得可否の詳細は以下の通りです。

パラメータ取得可否の検証結果

キー Direct Deferred 備考
deep_link_value ✅ 取得可 ✅ 取得可 管理画面で設定可
deep_link_sub1 ✅ 取得可 ✅ 取得可 管理画面で設定可
deep_link_sub210 ✅ 取得可 ✅ 取得可 管理画面で設定不可
deep_link_sub11 ✅ 取得可 取得不可 -
custom_key ✅ 取得可 取得不可 -

上記の内容は執筆時点(2026年3月)の調査結果です。AppsFlyerの仕様変更により情報が更新される可能性があるため、実装の際は必ず最新の公式ドキュメントをご参照ください。

実装にあたって考えたこと

URLの命名規則

ディファードディープリンクで渡すURLは、一度決めたら変更しにくい性質上、設計には慎重になりました。 今回アプリに渡す必要がある情報は、画面識別子・エリア情報・求人詳細ID・職種情報の4つです。ただし、これらの情報の性質は均一ではありません。画面識別子・エリア情報・求人詳細IDは遷移先の画面を決定するために必須の情報である一方、職種情報は絞り込み条件として画面に渡す付加的な情報です。後者はパラメータの種類や組み合わせが変わりやすく、将来的に増減したり仕様が変わったりする可能性もあります。こうした性質の違いを踏まえ、どのようにURLに乗せるかを以下の3案で検討しました。

案1:パラメータ分割方式

  • AppsFlyerの標準フィールド(deep_link_valuedeep_link_sub110)に各値を個別に割り振る方式
  • パラメータの意味がURL上で明確になる反面、sub10 までという上限があり将来的にパラメータが増えた際に対応できなくなるリスクがある
  • 「sub1はエリア情報」「sub2は職種情報」といったマッピング定義を厳密に管理し続ける必要があり、運用コストの面でも懸念があった

案2:URL埋め込み方式

  • deep_link_value にWebの完全なURLをエンコードして丸ごと格納する方式
  • 個数制限を気にせず済み、WebのURL構造をそのまま流用できる点は魅力的だった
  • アプリ独自の画面(Webに対応するURLが存在しない画面)を開きたい場合にダミーURLの設計が別途必要になる点が課題として残った

案3:ハイブリッド方式(採用)

  • deep_link_value に画面識別子、deep_link_sub1 に職種情報を含むWebの完全URL、deep_link_sub2 にエリア情報、deep_link_sub3 に求人詳細IDを入れる方式
  • アプリは deep_link_value だけを見れば遷移先を即座に判断でき、必須の求人詳細IDとエリア情報はそれぞれ deep_link_sub2deep_link_sub3 で確実に受け取れる。一方、職種情報など付加的な絞り込み条件は、WebのURLにクエリパラメータとして存在しているため、そのURL自体を deep_link_sub1 に格納することで、OneLinkのパラメータを増やすことなく柔軟に渡せる
  • URL生成ロジックが若干複雑になるデメリットはあるものの、拡張性と可読性のバランスが最もよいと判断し採用

議論を行い最終的に決まったパラメータの構成ルールは以下のとおりです。

パラメータキー 役割 値の例
deep_link_value 画面識別子 shopDetail など
deep_link_sub1 職種情報を含むURL https://example.com/kanto/work/100245?param={職種情報}...
deep_link_sub2 エリア情報 kanto
deep_link_sub3 求人詳細ID 100245
deep_link_sub4〜10 未使用 -

非同期での情報取得のタイミング

実装で最も苦労したのは、ディファードディープリンクの情報を非同期で取得するタイミングの制御です。

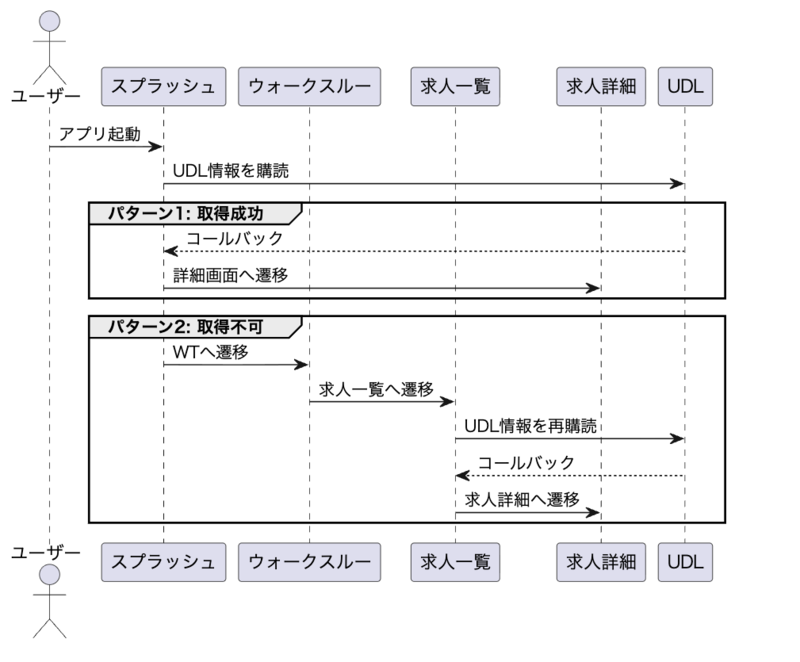
UDLのコールバックはアプリ起動後に非同期で返ってくるので、アプリの初期化処理との兼ね合いが厄介でした。 スプラッシュ画面にタイムアウト時間を設けて取得できなければコールバックを破棄する案なども検討しましたが、最終的には2つのタイミングでコールバックを受け取る方針に落ち着きました。コールバック受信時点でのアプリの状態に応じて処理を切り替えることで、データの到着が早くても遅くても、スムーズに画面遷移を繋げられるようになりました。

パターン1:スプラッシュ画面中にコールバックが返ってくるケース

  • スプラッシュ画面表示中にUDLから deep_link_value 等を取得
  • 取得した情報を解析し必要情報を端末に保存
  • ウォークスルーをスキップし、指定された求人詳細画面へ直接遷移

パターン2:スプラッシュ画面中にコールバックが返ってこないケース

  • コールバックが間に合わなかった場合、通常通りウォークスルーへ遷移
  • 求人一覧(TOP)画面に到達したタイミングで改めてUDL情報の取得を購読し、deep_link_value 等を受け取る
  • 遷移確認ダイアログをユーザーに表示し、同意が得られれば指定された求人詳細画面へ遷移する

なお、リンクを踏んでから15分以上経過して起動した場合は、UDLによる情報復元は行われず通常のアプリ起動として処理されます。

処理

まとめ

今回の開発を通じて、チームとしてディファードディープリンクを含むディープリンク周りの実装経験を得ることができました。Universal LinksやApp Linksといったシンプルなディープリンクとは異なり、ディファードはSDKの非同期処理やOS・端末ごとの挙動の差異など、実際に手を動かして初めてわかる複雑さがありました。そういった泥臭い部分を含め、チームで一つひとつ検証しながら実装を進めたことは、今後の開発においても大きな財産になると感じています。

また、ネット上には、SDKの繋ぎ込み方の記事はあっても、「URLの構成をどう設計したか」や「起動後の具体的な処理」にまで踏み込んだ事例は意外と少ないと感じました。

この記事が、同じようにディープリンクの実装で悩み、試行錯誤しているエンジニアの方々にとって、解決のヒントや一助となれば幸いです。
最後までお読みいただき、ありがとうございました。